TL;DR: Телеграм-userbot читает 57+ каналов, LLM анализирует каждое сообщение, HDBSCAN кластеризует тренды, а дайджест сам пишется и отправляется дважды в день. Всё работает локально на Qwen3.6 35B. Под катом — архитектура, нетривиальные решения и грабли, на которые я наступил.
С чего всё началось
Любое информационное поле — это хаос. Куча каналов, сайтов, множество сообщений в день. За этим не уследить. При этом 80% постов — либо реклама, либо перепосты одного и того же.
Идея простая: пусть машина читает всё, а человеку достаётся только суть. И реализация оказалась интереснее, комплекснее, чем изначально задумывалась.
В итоге вышел проект, который я назвал News Radar — пилотный, но рабочий. И именно о нём эта статья.
Я опишу в целом как работает проект и с чем столкнулся, это не подробный гайд по запуску.
Архитектура: что с чем разговаривает
Прежде чем лезть в детали, важно понять общую картину.
Telegram Channels (57+)
        │
        ▼
   COLLECTOR (Telethon userbot)
   читает каналы, сохраняет в SQLite
        │
        ▼
   DATABASE (SQLite WAL)
   sources, messages, analysis, trends, digests
        │
   ┌────┴────┐
   ▼         ▼
ANALYZER    API (FastAPI :8000)
LLM + BGE-m3    /feed /search /trends
ChromaDB        /digest /settings
TrendTracker         │
                     ▼
               Telegram Bot
               (команды + auto-digest)
Пять Docker-контейнеров: collector, analyzer, api, bot, chromadb. Все общаются через SQLite и HTTP. Никакого Kafka, никакого Redis — специально: хочется понять систему целиком, не прятать сложность за абстракциями.
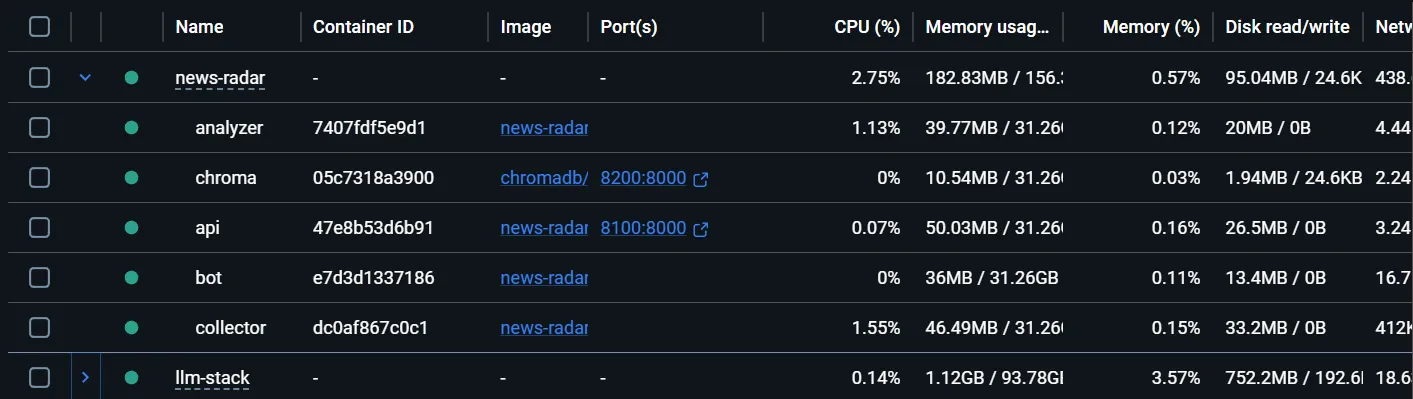
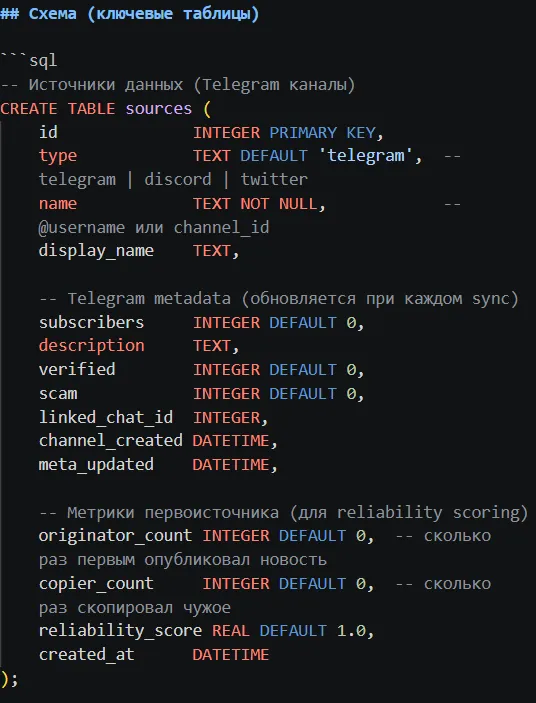
Collector — это Telethon userbot, который сидит в Telegram под реальным аккаунтом и читает все каналы из заданной папки. Он не анализирует и не думает — просто собирает сырые данные и складывает в базу. Views, реакции, пересылки, метаданные канала — всё идёт в SQLite.
SQLite — общая шина данных между всеми сервисами. Не Kafka, не Redis, просто файл с WAL-режимом. Collector пишет, Analyzer читает и пишет, API читает. Всё крутится вокруг одной базы, и это осознанный выбор: меньше движущихся частей, проще отлаживать.
Analyzer — сердце системы. Он забирает необработанные сообщения, прогоняет через эвристический фильтр рекламы, проверяет в ChromaDB нет ли уже похожего текста, и если нет — отправляет на LLM. Модель возвращает JSON: температуру новости от 1 до 10, тему, саммари, сентимент. Параллельно работает TrendTracker — он берёт эмбеддинги из ChromaDB, кластеризует через HDBSCAN и находит темы, о которых одновременно пишут сразу много каналов.
ChromaDB — отдельный контейнер с векторным хранилищем. Туда уходят BGE-m3 эмбеддинги каждого проанализированного сообщения. Используется для двух вещей: семантическая дедупликация перед LLM и поиск по смыслу через /search.
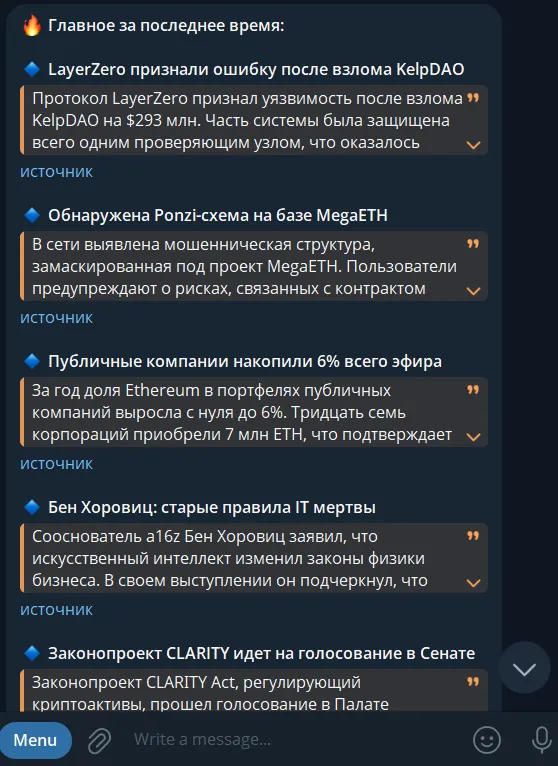
API + Bot — FastAPI отдаёт данные наружу, Telegram-бот их потребляет. Бот умеет присылать последний дайджест, показывать горячие тренды, принимать подписки на темы и генерировать дайджест по команде. Два раза в день — в 12:00 и 20:00 по Москве — дайджест уходит автоматически.
Поток данных линейный:
каналы → collector → SQLite → analyzer → ChromaDB + SQLite → API → бот → пользовательНикаких обратных связей, никаких очередей. Если что-то упало — данные лежат в базе и будут обработаны при следующем запуске.
Collector: userbot
Здесь первая нетривиальная вещь. Обычный Telegram-бот не может читать чужие каналы — он отвечает только на команды. Нужен userbot на реальном аккаунте через Telethon.
Принцип работы: нужен клиент через который при первом запуске вводишь SMS-код, сессия сохраняется в файл. Дальше userbot читает все каналы, в которых состоит аккаунт. Можно создать свое приложение и использовать его Telegram API hash (my.telegram.org) Либо можно обще доступный взять, но лучше свой, безопасней.
Фильтрация происходит на уровне Telegram-папок. Создал папку Ton/DeFi в Telegram, добавил туда нужные каналы — collector автоматически подхватывает их список через GetDialogFiltersRequest. Хочу добавить канал — просто кидаю его в папку, перезапускать ничего не нужно.
Catchup + real-time параллельно
При старте нужно решить задачу: догнать пропущенные сообщения и одновременно слушать новые. Если делать последовательно — пока догоняешь (это может занять минуты), новые события теряются.
await asyncio.gather(
    listen_loop(),       # Real-time сразу при подключении
    catchup_then_done(), # Догоняем пропущенное параллельно
    cfg.watch(),         # Следим за изменениями конфига
)
INSERT OR IGNORE в базе защищает от дублей, если одно и то же сообщение придёт из обоих потоков.
Forward tracking
Многие каналы — агрегаторы: они пересылают чужие посты. Важно понимать, кто первым опубликовал новость. Для этого сохраняем forward_from_channel и forward_from_msg_id из метаданных пересылки. Позже это используется в подсчёте уникальных источников тренда.
База данных: SQLite
Я выбрал SQLite с WAL-режимом. Схема написана так, что при необходимости легко мигрировать на PostgreSQL — структура идентична. Но для одной машины SQLite справляется отлично.
Ключевые решения:
conn = sqlite3.connect(path, check_same_thread=False, timeout=30)
conn.execute("PRAGMA journal_mode=WAL")
conn.execute("PRAGMA busy_timeout=30000")  # 30 сек retry при lock
WAL позволяет читателям не блокировать писателей. busy_timeout решает проблему конкурентного доступа collector + analyzer: вместо мгновенной ошибки SQLite ждёт освобождения до 30 секунд.
Миграции — пара (name, sql), выполняются ровно один раз. Если колонка уже есть (duplicate column) — миграция помечается как применённая без ошибки. Безопасно при перезапусках.
Analyzer: сердце системы
Здесь происходит всё самое интересное. Цикл запускается каждые 30 минут или при накоплении достаточного количества необработанных сообщений.
Приоритизация
Не все сообщения одинаково важны. Порядок обработки:
ORDER BY COALESCE(m.views, 0) DESC, length(m.text) DESC, m.collected_at DESCПосты с высоким engagement обрабатываются первыми. Если пришло 200 новых сообщений, а лимит батча 50 — LLM увидит самые горячие.
Два слоя фильтрации рекламы
Перед тем как тратить токены на LLM, проверяем текст эвристически:
# Layer 1: ключевые слова (мгновенно)
if any(kw in text.lower() for kw in ["#реклама", "на правах рекламы", "реферальная ссылка"]):
    mark_as_ad()
    return

# Layer 2: LLM (для неявной рекламы)
# "is_ad": true в JSON-ответе
Эвристика ловит явные случаи и экономит 30-40% LLM-запросов. LLM ловит тонкие: “этот токен изменит твою жизнь” — реклама, хотя слова “реклама” нет.
Семантическая дедупликация
Перед LLM-анализом проверяем: не обрабатывали ли мы уже похожее сообщение?
encode(text) → embedding (BGE-m3)
        │
ChromaDB.search(embedding, limit=1)
        │
similarity > 0.90? → клонируем AI-ответ из найденного
similarity < 0.90? → LLM analysis
На практике один и тот же релиз появляется в 10-15 каналах. Первый идёт на LLM, остальные получают клонированный результат. Экономия ~85-90% токенов на дублирующихся новостях.
LLM prompt
"""You are a crypto/financial news analyst.
CHANNEL: {source_name}
MESSAGE: {text}

Return ONLY valid JSON:
{
  "temperature": <1-10: 1-3 routine, 4-6 interesting, 7-8 hot, 9-10 BREAKING>,
  "topic": "bitcoin | ethereum | defi | hack/scam | ...",
  "summary": "<...>",
  "keywords": ["..."],
  "sentiment": "positive | negative | neutral",
  "is_ad": false
}

CRITICAL: If the post contains strong subjective opinions or sarcasm,
capture the author's main point and attitude. Do not reduce editorial
posts to dry facts only."""
Последний абзац — результат итерации. Без него LLM превращал мнения и сарказм в сухие факты, теряя голос автора канала. Для крипто-контента, где часто важна именно позиция, это критично.
Параллельные запросы к LLM
concurrency = cfg.get("llm_concurrency", 3)
sem = asyncio.Semaphore(concurrency)

# 3 параллельных LLM-запроса одновременно
tasks = [process_row(r) for r in batch]
results = await asyncio.gather(*tasks)
Qwen3.6 35B на 4090 держит 3 параллельных запроса без деградации. Throughput ~140 токен/с в llama.cpp (против ~85 в Oobabooga). Режим thinking включён — это +15-20 секунд на сообщение, но качество температурных оценок значительно лучше.
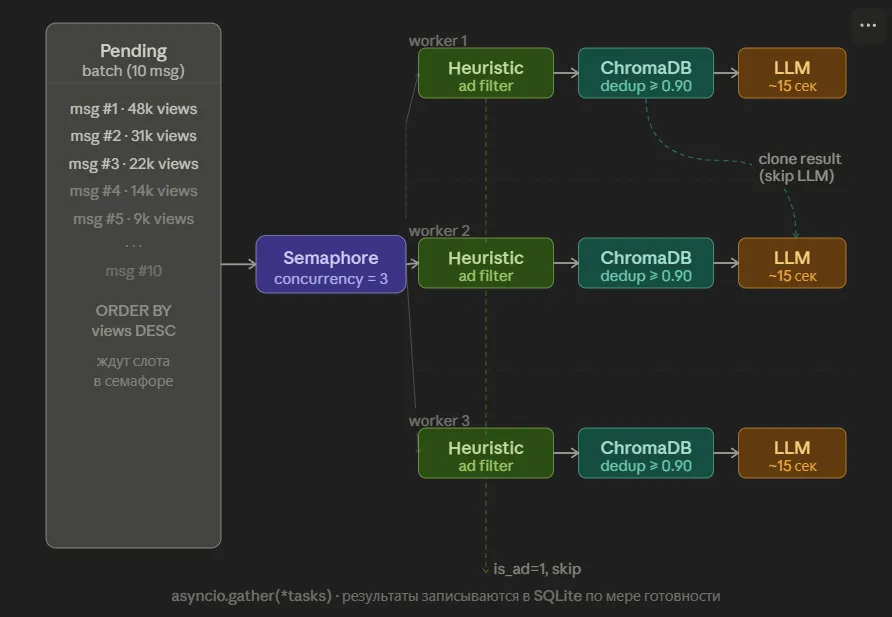
Параллельные запросы: батч сортируется по views (горячее — первым), затем Semaphore(3) пускает одновременно не более трёх воркеров. Каждый воркер проходит три этапа последовательно — эвристика → ChromaDB → LLM. Если эвристика поймала рекламу — дальше не идёт. Если ChromaDB нашла похожее (similarity ≥ 0.90) — клонирует результат и пропускает LLM. На LLM попадает только то, что прошло оба фильтра.
Embeddings и ChromaDB: векторный слой
Для семантики используется BGE-m3 — мультиязычная модель от BAAI. Поддерживает русский и английский (основные языки крипто-каналов), 1024 измерения, работает локально (~570 MB).
from sentence_transformers import SentenceTransformer

class Embedder:
    def encode(self, text: str) -> list[float]:
        vector = self._model.encode(text, normalize_embeddings=True)
        return vector.tolist()
normalize_embeddings=True — после нормализации косинусное сходство равно скалярному произведению. Это то, что использует ChromaDB.
ChromaDB работает в отдельном контейнере. Каждый документ — одно проанализированное сообщение, в метаданных — source, timestamp, temperature, topic.
Важный момент: ChromaDB может упасть (OOM killer в Docker). При этом коллекция исчезает. Решение — reconnect + retry:
def _reconnect_if_collection_lost(self, e: Exception):
    if "does not exist" in str(e) or "404" in str(e):
        self._connect(force=True)
        return True
Ошибка не фатальна — анализ продолжается, ChromaDB восстанавливается при следующем вызове.
TrendTracker: кластеризация трендов
Идея простая и мощная:
Когда множество разных каналов независимо пишут об одном и том же — это горячая новость.
Не нужен ML с разметкой. Нужна кластеризация.
HDBSCAN вместо BERTopic
Почему не BERTopic? Он заново кодирует тексты. У нас уже есть эмбеддинги в ChromaDB. Берём их напрямую:
arr = np.array(embeddings, dtype=np.float32)
clusterer = HDBSCAN(
    min_cluster_size=2,
    metric="euclidean",             # для нормализованных = cosine-equivalent
    cluster_selection_epsilon=0.25,   # tunable через конфиг
    core_dist_n_jobs=1,
)
labels = clusterer.fit_predict(arr)
Значение epsilon подбирал вручную: 0.35 — слишком мало кластеров, несвязанные новости сливались. 0.15 — слишком много, один тренд разбивался на части. Остановился на 0.25 с возможностью менять через конфиг без пересборки.
TrendScore
score = (
    unique_sources          # главный множитель
    * avg_temperature
    * math.exp(-0.3 * hours_since_first)  # decay: через 2.3ч = 0.5
    * (1.0 + math.log1p(avg_views))
)
unique_sources — самый важный фактор. 10 разных каналов о событии важнее, чем один канал с temperature=10.
Жизненный цикл тренда
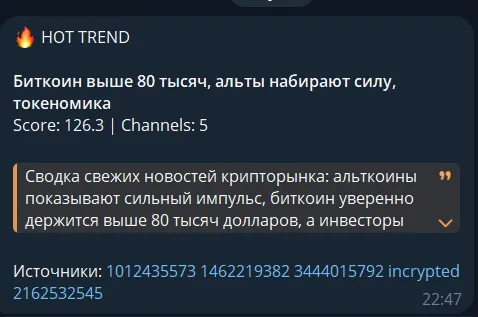
emerging → hot → cooling → deadПри достижении hot и ≥5 уникальных источников — алерт уходит в Telegram. Один раз, не при каждом цикле: проверяется alerted_at IS NULL.
Digest: дайджест на автопилоте
Дайджест генерируется дважды в день (12:00 и 20:00 МСК) или по команде /digest new.
Четыре уровня приоритета
# 1. ALERTS: hack/scam или temperature >= 9 — всегда первыми
# 2. TRENDS: сообщения из горячих трендов
# 3. HIGH: temperature >= базовый + 2
# 4. FILL: по одному лучшему от каждого оставшегося топика
max_per_topic = 1 — одна тема не может заполнить весь дайджест.
Три слоя дедупликации
- Semantic (ChromaDB, similarity > 0.85) — убирает почти одинаковые сообщения
- Cross-digest (против предыдущих 2 дайджестов, порог 0.75) — если тема была вчера, она идёт в секцию “Продолжение”, не как новая
- Topic cap — не более 1 элемента на топик
Эмоциональный баланс
Если предыдущий дайджест начинался с негатива (hack, crash, liquidation) — следующий не должен. Пользователь (Я) не хочет видеть два подряд депрессивных дайджеста:
if prev_was_negative:
    selected = non_negative[:2] + negative_items + non_negative[2:]
Два шаблона: Classic и Spoiler
Classic: LLM генерирует готовый Markdown-текст для Telegram.
Spoiler: LLM возвращает JSON со структурой, Python рендерит HTML с <blockquote expandable> — сводка скрыта под катом, разворачивается по нажатию. Решает проблему длинных дайджестов.
lines.append(f"🔹 <b>{title}</b>")
lines.append(f"<blockquote expandable>{summary}</blockquote>")
lines.append(f'<a href="{source_url}">источник</a>')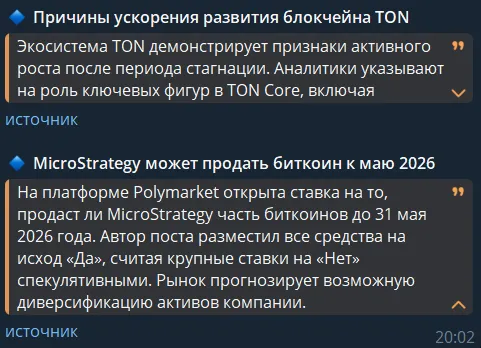
Config Hot-Reload: без перезапуска контейнеров
Раньше чтобы изменить breaking_alert_min_temp — нужен был рестарт. В Docker это downtime.
Решение: watchdog + callbacks.
class ConfigWatcher:
    async def watch(self):
        observer = PollingObserver(timeout=3)  # не inotify!
        # ...

    def on_change(self, key: str, callback: Callable):
        self._callbacks.setdefault(key, []).append(callback)
Почему PollingObserver, а не inotify? Потому что inotify не работает в Docker Desktop на Windows — файловые изменения с хоста невидимы для Linux inotify. Polling работает везде, latency 3 секунды — для конфига приемлемо.
# Пример: смена папки Telegram без рестарта
cfg.on_change("telegram_folder", lambda folder: collector._sync_dialogs(folder))
Agent Mode: OpenClaw
Самая экспериментальная часть. Есть два режима:
Legacy: Analyzer → LLM → Digest → Telegram

Agent:  Analyzer → OpenClaw → Narrative Digest → API → Telegram
OpenClaw — внешний AI-агент, который получает текстовые события и сам решает что делать: написать narrative-дайджест, отправить алерт, ответить на вопрос пользователя из /ask.
Честно скажу про ограничение: на локальной машине с 4090 Qwen3.6 35B держит только ~24K токенов контекста. Для полноценного агентного режима с длинной историей диалога этого не хватает. На моём сценарии (короткие events, небольшой контекст) — работает. Но для тяжёлых агентных задач нужно либо больше VRAM, либо меньшая модель.
В основном делал для баловства и теста библиотеки и практики.
Межпроцессный lock
Проблема: analyzer генерирует дайджест → одновременно запускается цикл анализа → LLM перегружается.
Решение — файловый lock на shared volume:
LLM_LOCK_FILE = "/app/data/llm.lock"

# В generate_digest():
with LLMLock():
    result = await llm.complete_json(...)

# В analyze_pending():
if is_llm_locked():
    return 0  # пропускаем цикл
Работает между Docker-контейнерами через общий volume data/.
Проблемы, на которые наступил
Ни один проект не обходится без граблей. Самые показательные:
Stale alerts на старте. После перезапуска или запуска ибо ночью я компьютер то вырубаю чтобы спать в тишине. collector догонял тысячи пропущенных сообщений. TrendTracker сразу кластеризовал их и слал алерты для трендов, которые были горячими неделю назад. Решение: is_fresh = (now - last_seen) < 2 hours — алерт только для свежих трендов.
LLM hallucinating URLs. LLM генерировал ссылки на источники прямо в тексте и мог придумать несуществующие или порядок изменить. Теперь URL строится только из данных БД через source_map: LLM получает [1], [2], Python подставляет реальные ссылки.
Private channels. Telegram использует разные форматы URL для публичных и приватных каналов: t.me/channel/123 vs t.me/c/123456789/123. Числовой ID нужно обрабатывать отдельно, убирая -100 префикс.
Двойные кавычки в HTML. Telegram HTML-парсер отвергает одинарные кавычки в атрибутах href. Казалось бы, мелочь, но дайджест просто не отправлялся.
Author voice в LLM. Модель превращала саркастичные или эмоциональные посты в скучные факты. Добавил в prompt явное требование сохранять субъективную позицию автора — качество саммари сразу выросло.
Итог: что получилось
News Radar — это не продукт, это учебный проект с реальным результатом. Я пользуюсь им каждый день: два дайджеста, алерты на breaking news, /hot когда хочу быстро глянуть тренды.
Что получилось понять и пощупать руками:
- Как строить pipeline с LLM на локальной железке
- Как работает векторный поиск и семантическая дедупликация на практике
- Что такое агентность в реальных условиях (с её ограничениями)
- Как делать RAG-системы, которые реально работают
Стек: Python, Telethon, FastAPI, SQLite, ChromaDB, BGE-m3, Qwen3.6 35B (llama.cpp), HDBSCAN, python-telegram-bot, Docker.
От этого проекта можно идти в разные стороны: добавить Twitter/Discord как источники, сделать персонализацию под каждого пользователя, улучшить агентный режим когда появится больше VRAM, построить RAG поверх накопленной базы.
Хотелось бы написать о другом проекте — Polymarket-trading UI, там уже другой масштаб и другие интересные приколюхи. Но сначала напишу отдельно про RAG систему, что новоял из новостей.